Рендеринг страниц JavaScript: что видят поисковые роботы и как это влияет на SEO
Страница открывается в браузере, заголовок на месте, каталог заполнен товарами, фильтры работают, текст виден. Кажется, что с индексацией тоже всё должно быть в порядке.
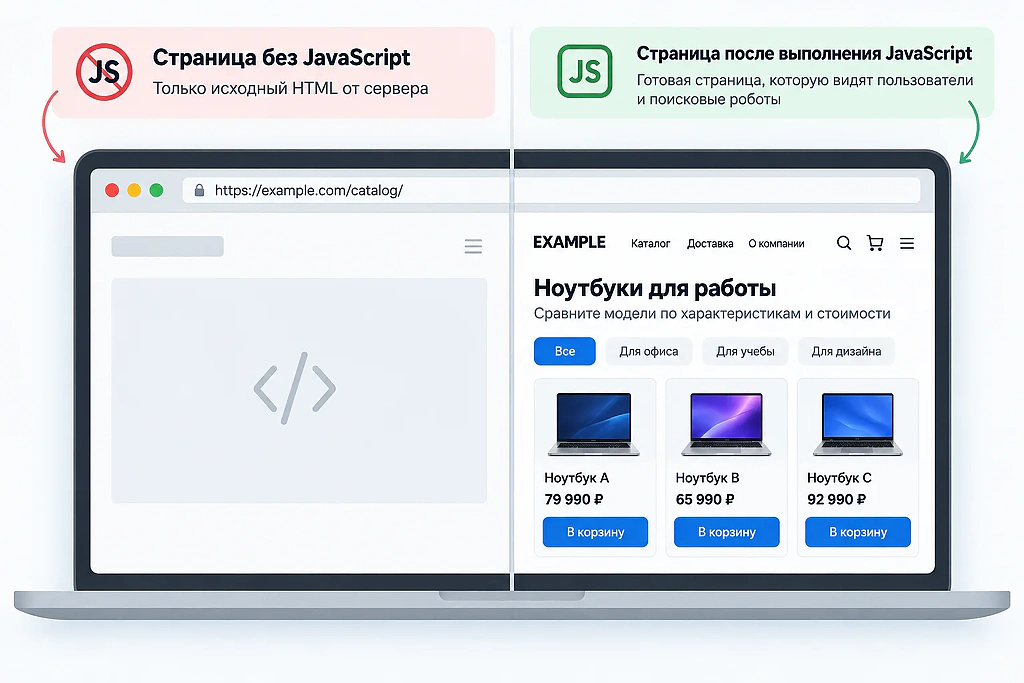
Но то, что видит пользователь после загрузки страницы, и то, что сервер отдал в исходном HTML, — не всегда одно и то же. На JavaScript-сайтах часть контента может появляться только после выполнения скриптов. Именно здесь и возникает вопрос рендеринга: получит ли поисковая система в итоге тот же основной контент, ссылки и метаданные, которые доступны посетителю.
Сам JavaScript не является проблемой для SEO. Google выполняет JavaScript и использует отрисованный HTML при обработке страниц. Однако реализация имеет значение: если важный элемент не появился после рендеринга, Google не сможет использовать его для индексирования.
Разберемся, что такое рендеринг страниц, чем исходный HTML отличается от итогового DOM, как выглядит сайт без JavaScript и что именно стоит проверять SEO-специалисту.
Что такое рендеринг страницы
Рендеринг — это процесс, в результате которого браузер превращает HTML, CSS, JavaScript и полученные данные в готовую страницу.
У простого HTML-сайта большая часть содержимого уже приходит от сервера:
<h1>Ноутбуки для работы</h1>

<p>Сравните модели по характеристикам и стоимости.</p>

<a href="/catalog/">Перейти в каталог</a>
Такой контент можно увидеть практически сразу после получения HTML.
У JavaScript-приложения первоначальный ответ сервера может выглядеть иначе:
<div id="app"></div>

<script src="/main.js"></script>
Самого заголовка, текста, карточек и ссылок здесь пока нет. JavaScript должен выполниться, получить данные и добавить элементы в документ.
После рендеринга результат может выглядеть уже так:
<div id="app">
    <h1>Ноутбуки для работы</h1>
    <p>Сравните модели по характеристикам и стоимости.</p>
    <a href="/catalog/">Перейти в каталог</a>
</div>
Для пользователя разница почти незаметна: он просто открывает страницу и через короткое время видит готовый интерфейс. Для SEO разница принципиальна — поисковой системе необходимо получить, обработать и корректно отрисовать этот контент.
Исходный HTML, страница без JavaScript и rendered HTML — это не одно и то же
При проверке JavaScript-сайта часто смешивают три разных состояния страницы.
| Что проверяем | Что это показывает |
|---|---|
| Исходный HTML | Ответ, который сервер отправил до выполнения JavaScript |
| Страница с отключенным JavaScript | Что браузер способен показать без исполнения клиентских скриптов |
| Rendered HTML / DOM | Итоговый документ после выполнения JavaScript |
Поэтому фраза «отключили JavaScript — страница пустая, значит поисковик ничего не видит» слишком упрощает ситуацию.
Google умеет выполнять JavaScript. В своей документации Google описывает обработку JavaScript-страницы в три этапа: сканирование, рендеринг и индексирование. Сначала робот получает URL и HTML-ответ, затем страница может быть отрисована с помощью Chromium, после чего Google анализирует уже полученный rendered HTML.
Отключение JavaScript полезно прежде всего как диагностический прием. Оно быстро показывает, насколько страница зависит от клиентского рендеринга.
Что можно заметить без JavaScript
После отключения JS могут исчезнуть:
- основной текст страницы;
- H1 и другие заголовки;
- товары и карточки категорий;
- цены и характеристики;
- внутренние ссылки;
- пагинация;
- хлебные крошки;
- элементы навигации;
- часть метаданных;
- контент, который подгружается через API.
Если пропадает декоративная анимация — для SEO это обычно несущественно. Если вместе с JavaScript исчезает весь смысловой центр страницы, проверку стоит продолжить.
Как Google обрабатывает JavaScript
Схема в упрощенном виде выглядит так:
URL → получение HTML → сканирование → рендеринг → анализ итогового HTML → индексирование
Googlebot сначала получает ответ сервера. Для обычной страницы или SSR-сайта основной контент уже содержится в HTML.
На клиентском JavaScript-сайте первоначальный документ может представлять собой только оболочку приложения. Тогда Google должен выполнить скрипты, чтобы получить настоящий контент страницы.
Google указывает, что страницы с ответом 200 обычно отправляются в очередь на рендеринг, если индексирование не запрещено. Когда доступны вычислительные ресурсы, Web Rendering Service запускает страницу в Chromium, выполняет JavaScript и повторно анализирует отрисованный HTML, в том числе ссылки.
Здесь есть важный практический вывод: проверять нужно не только исходный код, но и результат рендеринга.
Google отдельно рекомендует использовать URL Inspection в Search Console или Rich Results Test. В этих инструментах можно посмотреть отрисованный DOM, загруженные ресурсы и ошибки JavaScript.
Как Яндекс работает с JavaScript
Яндекс также умеет выполнять JavaScript на страницах.
В Яндекс Вебмастере есть отдельный инструмент «Рендеринг страниц JavaScript». С его помощью можно управлять тем, следует ли роботу выполнять JavaScript при обходе сайта, а также сравнивать доступность контента.
По умолчанию используется режим «На усмотрение робота Яндекса». В этом случае поисковая система может самостоятельно оценивать полноту содержимого страницы с выполнением JavaScript и без него.
Дополнительно в инструменте «Проверка страницы» можно посмотреть, какой ответ получает робот и как выглядит доступный ему контент.
Поэтому для сайта, ориентированного одновременно на Google и Яндекс, недостаточно проверки только в браузере разработчика. Лучше сверять результат и через инструменты обеих поисковых систем.
Почему рендеринг влияет на SEO
Проблема появляется не потому, что на сайте есть React, Vue, Angular или другой JavaScript-фреймворк. Один и тот же стек можно реализовать по-разному.
SEO-риск возникает, когда поисковая система не получает значимые элементы страницы в той версии, которую в итоге обрабатывает.
Основной контент отсутствует в rendered HTML
Представим страницу категории. Пользователь видит:
- H1;
- 40 карточек товаров;
- цены;
- описание категории;
- ссылки на подкатегории.
Но данные загружаются только после выполнения внешнего API-запроса. Если запрос завершился ошибкой во время рендеринга, итоговый HTML может содержать только пустые контейнеры.
В браузере владельца сайта всё при этом работает — поэтому проблему легко не заметить.
Google прямо рекомендует проверять, присутствует ли ожидаемый контент в rendered HTML. Если элемента там нет, Google не сможет его индексировать.
Внутренние ссылки создаются некорректно
Для SEO важен не только текст, но и возможность обнаружить другие URL.
Google рекомендует использовать обычные ссылки <a> с атрибутом href. Ссылки можно добавлять в DOM через JavaScript, но они должны оставаться доступными для обработки роботом.
Например:
<a href="/services/seo/">SEO-продвижение</a>надежнее для обхода, чем элемент, который выглядит как ссылка, но открывает страницу только через обработчик onclick.
Если важные категории, товары или статьи доступны лишь через JS-события, краулер может обнаруживать структуру сайта хуже.
Контент появляется только после действия пользователя
Еще один риск — загрузка содержимого после:
- клика;
- прокрутки;
- открытия вкладки;
- наведения мыши;
- авторизации;
- подтверждения разрешения;
- выполнения другого пользовательского события.
Поисковый робот не обязан воспроизводить все действия реального посетителя.
Если содержимое важно для органического поиска, лучше проверить, появляется ли оно при обычном рендеринге URL без дополнительных действий.
JavaScript или API возвращает ошибку
Страница может получить корректный HTML и даже ответ 200, но сломаться позже:
HTML загрузился
↓
JavaScript запустился
↓
API не ответило
↓
товары не появились
Пользователь может не заметить проблему, если ошибка временная или зависит от региона, cookie, авторизации либо нагрузки.
Поисковый робот попадает в свои условия загрузки, поэтому версия страницы для него иногда отличается.
Метаданные формируются только на клиенте
Google допускает создание или изменение <title> и meta description с помощью JavaScript. Canonical также может задаваться через JS, хотя Google рекомендует по возможности задавать канонический URL непосредственно в HTML и не менять его на противоречащее значение после рендеринга.
Для SEO-аудита это означает: недостаточно открыть вкладку браузера и увидеть правильный Title. Нужно проверить итоговую версию, которую получил робот.
CSR, SSR и пререндеринг: в чем разница
Способ рендеринга определяет, на каком этапе появляется основной HTML-контент.
| Подход | Где формируется основной HTML | Что обычно получает робот первым |
|---|---|---|
| CSR — Client-Side Rendering | В браузере | HTML-оболочку и JavaScript |
| SSR — Server-Side Rendering | На сервере при запросе | HTML с основным содержимым |
| SSG / static rendering | Заранее при сборке | Готовый HTML |
| Prerendering | Заранее или отдельным сервисом | Отрисованную HTML-версию |
Client-Side Rendering
При CSR сервер может отдавать минимальную оболочку, а содержимое формируется браузером после запуска JavaScript.
Такой вариант сам по себе не означает плохое SEO: Google способен выполнять JavaScript. Но количество зависимостей увеличивается — необходимо, чтобы загрузились скрипты, отработали запросы к API и сформировался корректный DOM.
Server-Side Rendering
При SSR сервер формирует HTML для каждого запроса.
Условно поисковик сразу получает:
<h1>Ноутбуки</h1>
<div class="products">...</div>
а не пустой:
<div id="app"></div>JavaScript затем может подключиться и сделать страницу интерактивной.
Static rendering и пререндеринг
При статическом рендеринге HTML создается заранее. Такой подход часто подходит для страниц, содержание которых не требуется формировать заново для каждого пользователя.
Google рекомендует рассматривать server-side rendering, static rendering или hydration как нормальные долгосрочные решения. Dynamic rendering, при котором роботу специально отдается отдельная отрендеренная версия, Google сейчас рассматривает как обходной вариант, а не рекомендуемую архитектуру на будущее.
Значит ли это, что SSR всегда лучше для SEO
Нет.
Формула «CSR плохо, SSR хорошо» слишком грубая.
Для SEO важен результат:
- доступен ли URL;
- возвращает ли страница правильный HTTP-код;
- может ли робот обнаружить ссылки;
- появляется ли основной контент после рендеринга;
- корректны ли Title, canonical и robots;
- не блокируются ли необходимые ресурсы;
- нет ли ошибок во время выполнения JavaScript.
Если CSR-страница стабильно отрисовывается и поисковик получает весь необходимый контент, сам способ рендеринга не делает ее автоматически хуже.
В марте 2026 года Google даже убрал из своей документации устаревшую формулировку, из которой можно было сделать вывод, что использование JavaScript само по себе «усложняет» работу Google Search: компания отмечает, что Google уже много лет рендерит JavaScript.
Поэтому архитектуру стоит выбирать не ради формального «SEO-friendly», а с учетом стабильности рендеринга, производительности и требований проекта.
Как проверить рендеринг страницы для SEO
Самая полезная проверка — сравнить несколько версий одной страницы.
1. Посмотрите исходный HTML
Откройте исходный код страницы через view-source: или функцию «Просмотр кода страницы».
Найдите:
- H1;
- часть основного текста;
- карточки;
- ссылки;
- canonical;
- Title;
- structured data.
Если значимая информация присутствует уже здесь, зависимость от клиентского рендеринга ниже.
Если HTML почти пустой — это еще не доказательство проблемы, но сигнал перейти к следующему этапу.
2. Отключите JavaScript
Отключите JavaScript в браузере и перезагрузите страницу.
Сравните две версии:
с JavaScript → без JavaScript.
Отметьте, что исчезло.
Особое внимание стоит уделить не дизайну, а SEO-содержимому:
- главному заголовку;
- тексту;
- карточкам товаров и услуг;
- цене;
- внутренним ссылкам;
- пагинации;
- хлебным крошкам;
- данным товара;
- навигации.
3. Посмотрите DOM после выполнения JavaScript
Через DevTools откройте вкладку Elements.
Это уже не первоначальный HTML, а документ после изменений, сделанных JavaScript.
Например, в source может быть:
<div id="products"></div>а в DOM:
<div id="products">
    <a href="/product/1/">Ноутбук A</a>
    <a href="/product/2/">Ноутбук B</a>
</div>
Так можно быстро понять, какие элементы создаются динамически.
4. Проверьте URL через Google Search Console
Для Google основная проверка — URL Inspection.
Нужно посмотреть:
- доступность URL;
- HTTP-ответ;
- rendered HTML;
- загруженные ресурсы;
- ошибки JavaScript;
- фактически полученный контент.
Google рекомендует именно URL Inspection или Rich Results Test для диагностики JavaScript-страниц.
5. Проверьте страницу в Яндекс Вебмастере
В Яндексе полезны два инструмента:
Индексирование → Проверка страницы
и
Индексирование → Рендеринг страниц JavaScript.
Через них можно проверить доступность содержимого для робота и сравнить поведение страницы с выполнением JavaScript.
Что проверять в первую очередь
Если времени на большой аудит нет, начните с элементов, которые непосредственно определяют содержание и структуру страницы.
Критично проверить:
- H1.
- Основной текст.
- Товары, услуги или другой главный контент.
- Внутренние ссылки.
- Title.
- Canonical.
- Robots.
- Пагинацию.
- Structured data.
- HTTP-коды страниц.
Особенно внимательно стоит смотреть шаблонные страницы: категории, карточки товаров, страницы услуг и SPA-маршруты. Ошибка рендеринга одного шаблона может затронуть сразу большое количество URL.
Пример: страница видна пользователю, но SEO-контент зависит от JavaScript
Представим интернет-магазин.
Сервер возвращает:
<html>
<head>
    <title>Каталог</title>
</head>
<body>
    <div id="root"></div>
    <script src="/catalog.js"></script>
</body>
</html>
После загрузки JavaScript браузер получает данные API и создает:
<h1>Кофемашины</h1>

<p>Кофемашины для дома и офиса...</p>

<a href="/coffee-machine/model-1/">Модель 1</a>
<a href="/coffee-machine/model-2/">Модель 2</a>
Для пользователя всё выглядит нормально.
Но если API недоступно поисковому рендереру, итог может остаться таким:
<div id="root"></div>Вот это уже реальная SEO-проблема: дело не в том, что используется JavaScript, а в том, что важный контент не попал в результат рендеринга.
Частые ошибки при проверке JavaScript SEO
Смотреть только исходный код
Исходный HTML показывает лишь первый этап загрузки. На CSR-сайтах этого недостаточно.
Нужно сравнивать его с rendered DOM и версией поискового робота.
Считать пустую страницу без JS доказательством проблем с индексацией
Google и Яндекс способны выполнять JavaScript. Поэтому версия браузера с отключенным JS — диагностический сигнал, а не точная копия того, что видит робот.
Проверять только главную страницу
Главная может рендериться нормально, а категории, фильтры, карточки или статьи — через другой шаблон.
Проверять нужно несколько типовых URL каждого значимого шаблона.
Оценивать только наличие текста
Даже если текст присутствует, могут отсутствовать:
- ссылки;
- canonical;
- корректный HTTP-код;
- structured data;
- элементы пагинации;
- уникальный Title.
JavaScript SEO — это не только вопрос «видит ли Google текст».
Короткий чек-лист проверки рендеринга
Если нужно быстро понять состояние страницы, пройдите по цепочке:
1. Исходный HTML
Есть ли главный контент?
2. JavaScript отключен
Что исчезло?
3. Rendered DOM
Появилось ли всё после выполнения скриптов?
4. Ссылки
Есть ли обычные <a href> на важные URL?
5. Метаданные
Корректны ли Title, canonical и robots?
6. HTTP-коды
Возвращаются ли реальные 200, 301, 404, а не одинаковый 200 для всех состояний SPA?
7. Google Search Console
Есть ли контент в rendered HTML?
8. Яндекс Вебмастер
Какую версию получает робот?
9. API и ресурсы
Не блокируются ли скрипты и запросы, необходимые для загрузки контента?
10. Шаблоны
Проверены ли категории, карточки, услуги и другие типы страниц, а не только один URL?
Если важный элемент присутствует у пользователя, но отсутствует в версии поискового робота, проблему стоит рассматривать уже как техническую SEO-задачу.
ВОПРОСЫ И ОТВЕТЫ
Видит ли Google контент, который загружается через JavaScript?
Да. Google выполняет JavaScript и использует rendered HTML при индексировании. Однако конкретный контент должен успешно появиться в отрисованной версии страницы. Если после рендеринга его нет, Google не сможет его индексировать.
Индексирует ли Яндекс JavaScript?
Яндекс умеет выполнять JavaScript. В Яндекс Вебмастере есть отдельные инструменты для проверки и настройки рендеринга JavaScript-страниц.
Нужно ли, чтобы весь текст был виден без JavaScript?
Не обязательно. Поисковые системы способны обрабатывать JavaScript. Но чем больше критически важного контента зависит от клиентского рендеринга, тем больше компонентов должны корректно сработать до получения полной страницы.
Для важных посадочных страниц полезно минимизировать хрупкие зависимости и обязательно проверять фактически отрисованный HTML.
Как посмотреть сайт так, как его видит поисковик?
Обычного отключения JavaScript недостаточно.
Для Google лучше использовать URL Inspection в Search Console или Rich Results Test. Для Яндекса — «Проверку страницы» и «Рендеринг страниц JavaScript» в Вебмастере.
Может ли JavaScript мешать индексации?
Может, если из-за реализации важный контент не появляется в rendered HTML, ресурсы недоступны, ссылки невозможно обнаружить, страница возвращает неправильный статус или возникают ошибки при выполнении кода.
Само наличие JavaScript не означает проблем с SEO.
Что запомнить
Для SEO нет смысла спорить о JavaScript абстрактно. Проверять нужно конкретную страницу и конкретный результат.
Если исходный HTML почти пустой, это повод посмотреть, что произойдет дальше, а не сразу ставить диагноз.
Главный вопрос звучит так: получает ли поисковый робот после обработки страницы тот контент и те SEO-сигналы, которые мы рассчитываем продвигать?
Если H1, основной текст, ссылки, карточки, canonical и другие значимые элементы присутствуют в rendered HTML — клиентский JavaScript сам по себе не является препятствием.
Если пользователь видит полноценную страницу, а робот после рендеринга получает пустую оболочку или неполный документ, тогда нужно разбираться с архитектурой, JavaScript, API, доступностью ресурсов или способом рендеринга.